
ARTICOL SEO
Cum funcționează motoarele de căutare: crawling, indexare și clasare
Capitolul 2 din Manual SEO · Fundamentele SEO · Nivel: Începător
Pe scurt: Google nu afișează automat fiecare pagină publicată. Mai întâi trebuie să o descopere, să o poată analiza și să o considere relevantă pentru o căutare.

Ce se întâmplă între publicarea unei pagini și apariția ei în Google?
Ai publicat o pagină nouă, ai verificat că se deschide și aștepți vizitatori. Dar când cauți titlul ei în Google, nu apare nimic. Nu înseamnă automat că ai greșit ceva: publicarea pe site și apariția într-un motor de căutare sunt două lucruri diferite.
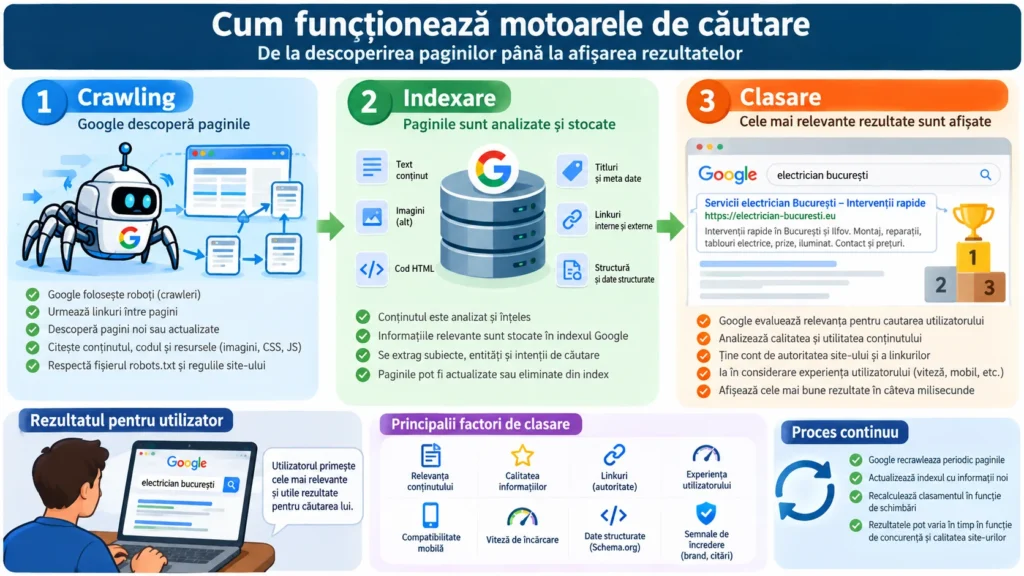
Pentru a putea afișa o pagină în rezultatele obișnuite, un motor de căutare trebuie, în linii mari, să o descopere, să îi poată analiza conținutul și să decidă dacă este potrivită pentru o anumită căutare. Cele trei noțiuni esențiale sunt crawling, indexare și clasare (ranking). Nu sunt garanții succesive: unele pagini nu sunt accesate, altele sunt accesate dar nu sunt indexate, iar multe pagini indexate nu apar pe primele poziții.
1. Crawling: cum descoperă Google paginile
Crawling-ul este procesul prin care programe automate, numite crawlere sau roboți, accesează URL-uri și urmăresc legăturile dintre ele. În cazul Google, unul dintre crawlerele cunoscute este Googlebot. El nu „navighează” ca un om, dar solicită pagini și resurse, interpretează răspunsurile și descoperă alte adrese.
O pagină poate fi descoperită printr-un link de pe altă pagină, printr-un sitemap XML sau prin alte semnale cunoscute motorului de căutare. Un sitemap ajută la descoperire, însă nu obligă Google să viziteze ori să indexeze fiecare adresă.
Ce poate împiedica accesarea?
- Un URL greșit sau o pagină care răspunde cu eroare 404 ori 500.
- Un server foarte lent, indisponibil sau care blochează Googlebot.
- Reguli din
robots.txtcare interzic accesarea anumitor căi. - O pagină fără linkuri interne, greu de descoperit.
- Resurse necesare afișării paginii care nu pot fi încărcate.
Exemplu: publici /servicii/montaj-prize/, dar nu adaugi niciun link către ea din meniu, pagina de servicii sau articolele relevante. Google o poate descoperi prin sitemap, însă o structură clară de linkuri interne îi ajută atât pe utilizatori, cât și pe crawlere.
2. Indexarea: ce înțelege motorul de căutare din pagină
După accesare, motorul de căutare poate analiza textul, titlul, imaginile, legăturile și alte elemente. Pentru anumite pagini, Google poate procesa și JavaScript-ul pentru a vedea conținutul rezultat. Indexarea înseamnă că informații despre pagină pot fi păstrate în indexul motorului de căutare, astfel încât pagina să poată fi luată în calcul pentru căutări.
Crawled nu înseamnă indexed. O pagină poate fi accesată și totuși să nu fie indexată. Google poate considera că este duplicată, foarte asemănătoare cu o altă pagină, insuficient de utilă sau poate întâmpina alte probleme. Uneori este doar o chestiune de timp.
Noindex, robots.txt și canonical: trei lucruri diferite
noindexeste o instrucțiune prin care ceri motoarelor de căutare să nu includă pagina în rezultate, dacă pot accesa și vedea instrucțiunea.robots.txtcontrolează accesarea prin crawling; nu este un mecanism sigur pentru a scoate un URL deja cunoscut din rezultate.rel="canonical"indică URL-ul preferat dintre pagini duplicate sau foarte asemănătoare; este un semnal, nu o comandă garantată.
Atenție la combinația dintre Disallow în robots.txt și noindex în pagină: dacă Google nu poate accesa pagina, este posibil să nu poată citi nici instrucțiunea noindex.
3. Clasarea: de ce unele pagini apar înaintea altora
Când cineva caută „electrician București”, Google încearcă să aleagă rezultate relevante pentru acea persoană și acea căutare. Pentru asta folosește numeroase sisteme și semnale. Nu există o formulă publică simplă și nici o listă de trucuri care să garanteze locul întâi.
Contează, printre altele, dacă pagina răspunde intenției utilizatorului, cât de util și de clar este conținutul, dacă site-ul poate fi folosit bine pe mobil și dacă informațiile par credibile. Pentru căutările locale, contextul geografic poate influența rezultatele. Pozițiile se pot schimba în funcție de interogare, locație, dispozitiv și moment.
Exemplu: două pagini despre servicii de electrician
Pagina A repetă de 30 de ori „electrician București”, dar nu spune ce intervenții face, în ce zone lucrează sau cum poate fi contactată firma. Pagina B descrie montajul prizelor, remedierea defecțiunilor, aria de acoperire, programul și modalitățile de contact. Pentru cine caută un serviciu concret, pagina B are șanse să fie mai utilă. Asta nu garantează o anumită poziție, dar ilustrează diferența dintre optimizarea pentru oameni și repetarea mecanică a expresiilor.
Cum verifici dacă o pagină este indexată
Cel mai bun punct de plecare pentru propriul site este Google Search Console. După ce verifici proprietatea, folosește instrumentul „Inspectarea adresei URL” (URL Inspection) și introdu adresa completă a paginii.
- Verifică dacă mesajul indică faptul că URL-ul este în Google sau nu.
- Consultă informațiile despre accesare, indexare și URL-ul canonical selectat de Google.
- Folosește „Testează adresa URL publicată” pentru a verifica starea accesibilă în prezent.
- Dacă pagina este eligibilă și importantă, poți solicita indexarea. Solicitarea nu garantează includerea și nu o accelerează întotdeauna.
- Verifică raportul „Indexarea paginilor” pentru probleme care afectează mai multe URL-uri.
Operatorul site:exemplu.ro/pagina/ poate oferi un indiciu rapid, dar nu este un test complet sau definitiv de indexare. Pentru site-ul tău, folosește în primul rând Search Console.
Cât durează până când o pagină apare în Google?
Nu există un termen fix. Descoperirea și indexarea pot dura de la câteva ore la câteva săptămâni sau mai mult; unele pagini nu sunt indexate deloc. Publicarea unui sitemap, adăugarea de linkuri interne și remedierea erorilor tehnice sunt măsuri utile, dar nu reprezintă un buton de „indexare instantanee”.
Greșeli frecvente de evitat
- Să crezi că o pagină publicată este automat indexată.
- Să confunzi indexarea cu poziția în rezultate: o pagină indexată poate apărea foarte jos.
- Să blochezi accidental secțiuni importante prin robots.txt sau noindex.
- Să publici multe pagini aproape identice doar pentru variații de cuvinte-cheie.
- Să verifici obsesiv căutarea site: și să ignori rapoartele Search Console.
- Să promiți clienților poziția 1 în Google ca rezultat garantat.
Exercițiu practic: urmărește traseul unei pagini
Alege o pagină importantă de pe site-ul tău. Notează URL-ul, verifică dacă este legată din meniu sau din alte pagini și dacă apare în sitemap. Apoi deschide Search Console, inspectează URL-ul și răspunde în scris la trei întrebări: Poate fi accesată? Este indexată? Pentru ce căutare ar fi utilă?
Dacă pagina nu este indexată, nu schimba tot site-ul dintr-odată. Citește motivul raportat, verifică accesibilitatea și conținutul, apoi corectează problema identificată.
Recapitulare
- Crawling = motorul de căutare descoperă și accesează pagini.
- Indexare = motorul de căutare poate analiza și păstra informații despre pagini în index.
- Clasare = pentru fiecare căutare, motorul selectează și ordonează rezultatele considerate relevante.
În capitolul următor vom discuta diferențele dintre rezultatele organice, reclamele Google Ads și rezultatele locale, ca să înțelegi exact unde poate apărea site-ul tău și ce poți influența prin SEO.